Van on-premises SQL Server naar een modern dataplatform in Microsoft Fabric
De transformatielogica van de klant zat verspreid over Power Query-dataflows, SQL-views en stored procedures. Niemand kon in één oogopslag zien waar een cijfer vandaan kwam, en een wijziging testen betekende hopen dat er niets omviel. We brachten die logica naar dbt, met alles in Git en een omgeving die als code beschreven staat.
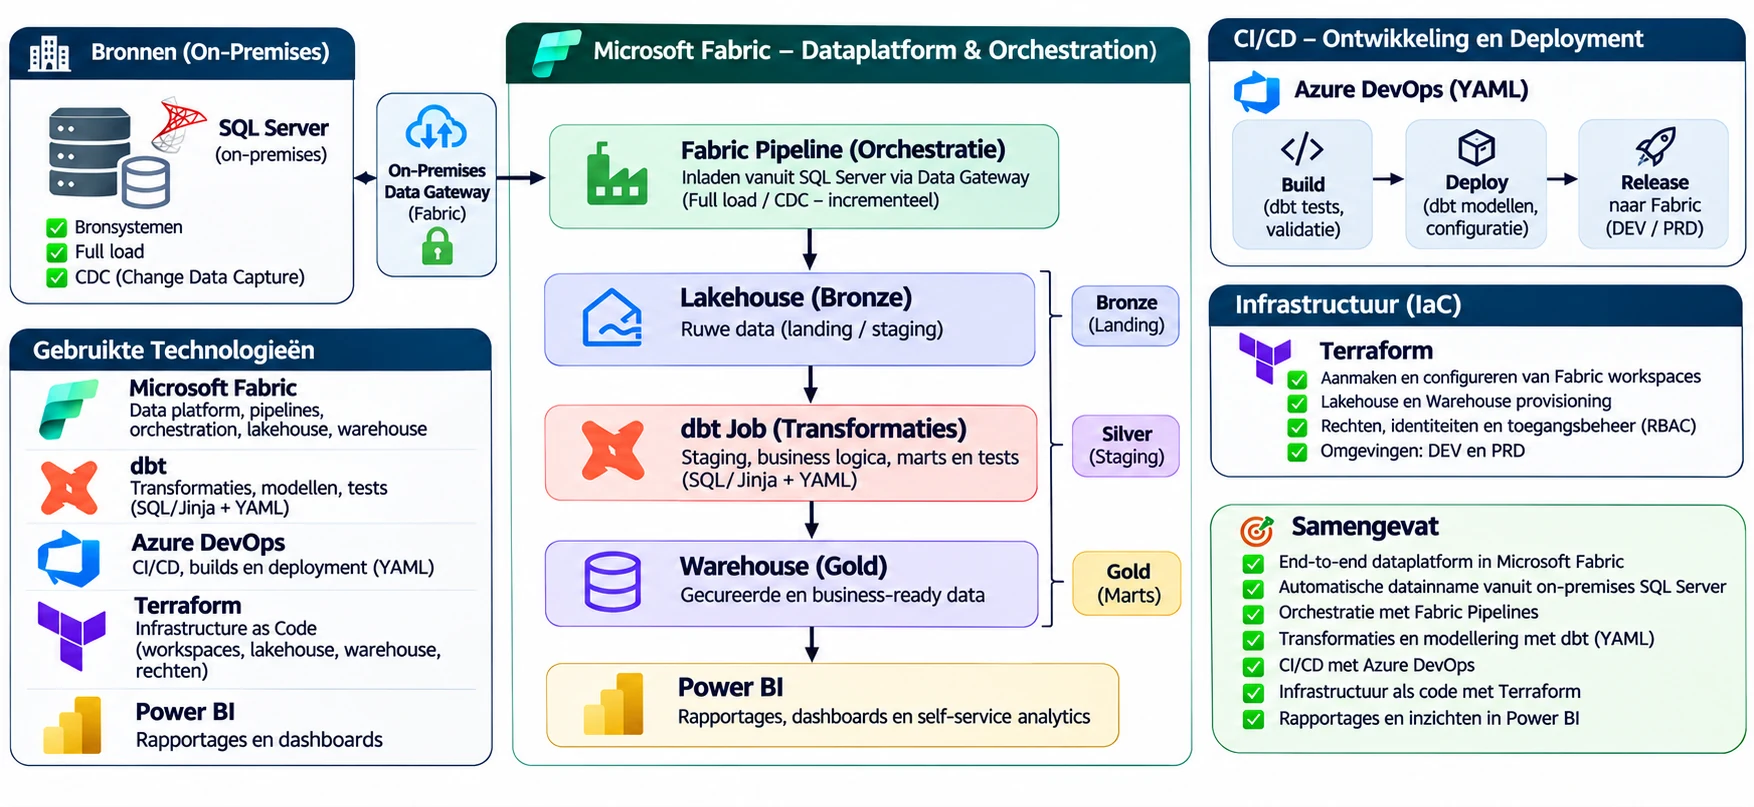
De architectuur in één beeld
Van de bron tot het rapport, met de ontwikkelstraat en de infrastructuur eromheen.
De aanpak
Geen big bang, maar een schone omgeving naast het bestaande, per domein gemigreerd. Het oude blijft draaien tot het nieuwe bewezen is.
Eerst uitzoeken waar de logica zit
We inventariseerden 50 dataflow-entiteiten en de views en stored procedures eronder. Conclusie: de dataflows bevatten zelf geen transformaties. De logica zit in SQL Server, dus de migratie is SQL overnemen en geen Power Query omzetten.
Inladen via een gateway
Brontabellen komen 1-op-1 in een Fabric-lakehouse, via de on-premises data gateway. De kleine tabellen worden volledig herladen; voor de grootste tabel draait CDC (Change Data Capture) elke 15 minuten.
Transformeren in dbt
Staging, geschiedenis, bedrijfsregels en marts staan als SQL en YAML in Git, met tests erbij. Herkomst van een cijfer is terug te volgen tot de bron.
Elke wijziging door CI/CD
Een pull request bouwt en test in een eigen schema in de warehouse, zodat niemand elkaars werk overschrijft. Pas na goedkeuring gaat een wijziging naar de hoofdlijn.
De omgeving als code
Workspaces en rechten staan in Terraform. Toegang loopt via groepen en niet per persoon, en een tweede omgeving is een kwestie van configuratie.
Drie lagen, strikt gescheiden
Elke laag heeft één taak. Zo weet je altijd waar je moet zoeken, en waar een bedrijfsregel wel en niet hoort.
Lakehouse: de landingszone
Brontabellen uit SQL Server, onbewerkt overgenomen en met dezelfde namen als in de bron. Er gebeurt hier niets met de data, zodat je altijd naar de bron kunt terugkijken.
dbt: opschonen en verrijken
Staging-views hernoemen, casten en typen. Snapshots leggen de geschiedenis vast die de bron zelf niet bewaart, en tussenstappen bevatten de bedrijfsregels.
Warehouse: de marts
Fysieke tabellen waar Power BI op draait. Een mart is een vaste momentopname van een dbt-run en verandert niet tussen twee refreshes.
Alles in één repo
Het platform, de transformaties en de uitleg erbij staan bij elkaar in Git. Wie wil weten waarom iets is zoals het is, hoeft maar op één plek te kijken.
De workspace gekoppeld aan Git
De Fabric-workspace synchroniseert met de repo: de items in de workspace staan er als bestanden in. Wat iemand in de workspace aanpast, is daarmee terug te zien in de historie in plaats van alleen in het scherm.
Infrastructuur en modellen naast elkaar
In dezelfde repo staan de Terraform-modules voor de omgeving en de rechten, het dbt-project met de modellen en tests, en de Fabric-items. Een wijziging die zowel de inrichting als een model raakt, is daardoor één pull request.
De documentatie in de wiki ernaast
Keuzes, afspraken en werkinstructies staan in de wiki van hetzelfde project, niet in losse documenten op een schijf. Die wiki staat zelf ook in Git, dus de uitleg verandert mee met de code in plaats van erachteraan.
Waar staat het nu
De architectuurplaat laat het doelbeeld zien. Dit draait al, en dit niet.
Staat en draait
- Brontabellen in het lakehouse, met CDC voor de grootste tabel
- dbt-keten van bron tot mart, met tests bij elke wijziging
- Klant- en datumdimensie in de gold-laag
- Adresgeschiedenis via een snapshot (SCD type 2)
- CI/CD in Azure DevOps, per pull request in een eigen schema
- Workspaces en toegangsrechten in Terraform
- De Fabric-workspace gekoppeld aan Git, met de items als bestanden in de repo
Nog onderweg
- De omzetketen: de oorspronkelijke view berekent kolommen die in de brontabel niet staan
- Orkestratie in een Fabric-pipeline die inladen en dbt aan elkaar koppelt
- Een volwaardige productieomgeving naast ontwikkeling
Wat we onderweg leerden
Dit zijn de dingen die je op papier niet ziet en in de praktijk wel raakt.
Zoek eerst waar de logica echt zit
De dataflows leken het hart van de transformaties, maar bleken doorgeefluiken. Had niemand dat gecontroleerd, dan was er maanden Power Query omgezet dat niets deed.
Een tabel is niet hetzelfde als de view erop
Een view kan kolommen berekenen die op de brontabel ontbreken. Zonder de definitie van die view is nabouwen gokken, en dan wijken de cijfers af van het rapport zonder dat iemand weet waarom.
Het lakehouse let op hoofdletters, de bron niet
Dezelfde sleutel bleek in twee tabellen anders geschreven. We lazen de schema’s uit het lakehouse zelf in plaats van ze uit de bron over te nemen, en de modellen bouwden meteen.
Meet voordat je incrementeel laadt
Bij de grootste tabel had een deel van de rijen geen wijzigingsdatum. Incrementeel laden op die kolom had die rijen stil overgeslagen; CDC ziet wijzigingen wel, ook zonder zo’n kolom.